Büyük dil modeli (LLM) çıkarımı için gereken işlem gücü, model boyutlarının büyümesi, gerçek zamanlı gecikme gereksinimleri ve en son olarak yapay zekâ ile akıl yürütme (AI reasoning) gibi faktörlerin etkisiyle hızla artıyor. Aynı zamanda, yapay zekânın benimsenmesiyle birlikte bir AI fabrikasının mümkün olan en fazla kullanıcıya hizmet verirken, kullanıcı başına iyi deneyimler sunabilmesi, ürettiği değeri en üst düzeye çıkarmak için kritik hâle geliyor. En yeni modellerde yüksek çıkarım verimi ve düşük çıkarım gecikmesi sağlamak, silikon donanımdan ağ sistemlerine ve yazılıma kadar tüm teknoloji yığınında mükemmellik gerektirir.
MLPerf Inference v5.0, farklı modeller ve kullanım senaryoları genelinde çıkarım verimini ölçen uzun soluklu bir benchmark serisinin en yeni sürümüdür. İlk olarak 2019’da tanıtılan MLPerf Inference, yeni modeller ve senaryolarla düzenli olarak güncellenerek, AI bilgi işlem platformlarının çıkarım performansını ölçmek için yararlı bir araç olmaya devam ediyor.
Bu turda üç yeni benchmark eklendi:
-
Llama 3.1 405B: 405 milyar parametreli yoğun bir LLM. Sunucu senaryosu için benchmark, ilk token süresi (TTFT) için 6 saniye ve çıktı token başına süre (TPOT) için 175 ms gecikme sınırları belirliyor.
-
Llama 2 70B Interactive: 70 milyar parametreli yoğun bir LLM. Bu iş yükü, ilk kez MLPerf Inference v4.0’da tanıtılan Llama 2 70B modeline dayanıyor; ancak 450 ms TTFT ve 40 ms TPOT (kullanıcı başına saniyede 25 token) ile daha sıkı gecikme kısıtlamalarına sahip.
-
Relational Graph Attention Network (R-GAT): Bir grafik sinir ağı (GNN) benchmark’ı. GNN’ler; sosyal ağ analizi, ilaç keşfi, dolandırıcılık tespiti ve moleküler kimya gibi birçok alanda uygulanmaktadır.
Bu yeni benchmark’lar; ResNet-50, RetinaNet, 3D U-Net, DLRMv2, GPT-J, Stable Diffusion XL, Llama 2 70B ve Mixtral 8x7B gibi çok çeşitli model ve kullanım senaryolarını kapsayan mevcut testlere eklendi.
NVIDIA, veri merkezi kategorisindeki tüm benchmark’lara sonuç göndererek, yeni eklenen Llama 3.1 405B, Llama 2 70B Interactive ve GNN testlerinde de üstün performans sergiledi. Bu turda NVIDIA, hem NVIDIA GB200 NVL72 hem de NVIDIA DGX B200 sistemlerini kullanarak Blackwell mimarisiyle birçok sonuç sundu ve önceki nesil Hopper mimarisiyle karşılaştırıldığında önemli hız artışları elde etti. Ayrıca Hopper mimarisi, yazılım iyileştirmeleri sayesinde üç yıl sonra bile mükemmel performans göstermeye devam etti.
Blackwell, MLPerf’te Yeni Performans Standardını Belirliyor
NVIDIA Blackwell mimarisi, 2024 NVIDIA GTC’de tanıtıldı ve şu anda büyük bulut hizmet sağlayıcıları ile birçok sunucu üreticisi tarafından tam üretim aşamasında kullanılmakta. Blackwell, ikinci nesil Transformer Engine, beşinci nesil NVLink, FP4 ve FP6 hassasiyetleri gibi birçok mimari yenilik içeriyor ve bu sayede hem eğitim hem de çıkarım işlemleri için olağanüstü performans sağlıyor.
Blackwell platformu, farklı veri merkezi uygulamaları için çeşitli sistem formatlarında sunuluyor. NVIDIA, hem 36 Grace CPU ve 72 Blackwell GPU içeren rack-scale sistemi GB200 NVL72, hem de sekiz Blackwell GPU içeren DGX B200 sistemleri ile sonuçlarını sundu.
Ayrıca bu turda, Llama 3.1 405B, Llama 2 70B Interactive, Llama 2 70B ve Mixtral 8x7B benchmark’larında ikinci nesil Transformer Engine, FP4 Tensor Cores, verimli model çalıştırma için NVIDIA TensorRT-LLM yazılımı ve TensorRT Model Optimizer ile FP4 quantization teknolojileri kullanıldı. Bu teknolojilerin birleşimi sayesinde Blackwell, benchmark doğruluk gereksinimlerini karşılarken FP4 hassasiyetiyle iki kat daha fazla işlem hacmi sunabildi.
Llama 3.1 405B benchmark’ında:
GB200 NVL72, sekiz H200 GPU’lu sisteme kıyasla GPU başına 3.4 kata kadar daha yüksek performans sundu.
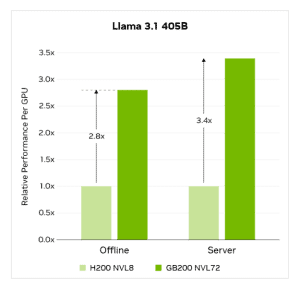
Sistem düzeyinde ise, GB200 NVL72, tek bir NVLink alanı üzerinde birbirine bağlı 9 kat daha fazla GPU ile performansı 30 kata kadar artırıyor.

NVIDIA ayrıca MLPerf Inference v4.1’deki Llama 2 70B benchmark’ını da GB200 NVL72 üzerinde çalıştırarak, 869.203 token/saniye gibi doğrulanmamış bir sonuç elde etti.
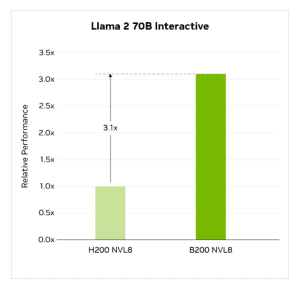
Llama 2 70B Interactive benchmark’ında:
Sekiz GPU’lu B200 sistemi, sekiz H200 GPU’lu NVIDIA sistemine göre 3.1x daha yüksek çıkarım verimi sundu.
Diğer Benchmark’larda Blackwell’in Avantajı
Aşağıdaki tabloda, sekiz Blackwell GPU’lu B200 sistemin bazı benchmark’larda sekiz H200 GPU’lu sisteme kıyasla sağladığı hız artışları yer alıyor:
| Benchmark | 8x B200 GPU (Tokens/s) | 8x H200 GPU (Tokens/s) | Blackwell Hız Artışı |
|---|---|---|---|
| Llama 2 70B | 98.443 / 98.858 | 33.072 / 34.988 | 3x / 2.8x |
| Mixtral 8x7B | 126.845 / 128.148 | 61.802 / 62.630 | 2.1x / 2.1x |
| Stable Diffusion XL | 28.44 / 30.38 | 18.30 / 18.99 | 1.6x / 1.6x |
Hopper Hâlâ Güçlü
Hopper platformu, Mart 2022’de tanıtılmasından bu yana çıkarım performansı konusunda sektör liderliğini koruyor. MLPerf Inference v5.0’daki en zorlu görevlerden olan Llama 3.1 405B ve Llama 2 70B Interactive benchmark’larında da güçlü performans sergiledi.
Hopper, yeni yazılım güncellemeleriyle Llama 2 70B çıkarım verimini son bir yılda 1.5x artırdı. Bu artışta:
-
GEMM ve attention çekirdek optimizasyonları
-
Gelişmiş çekirdek birleşimleri (kernel fusion)
-
Chunked prefill optimizasyonları
-
TensorRT-LLM içerisindeki pipeline parallelism iyileştirmeleri
önemli rol oynadı.
NVLink Switch sayesinde tüm GPU’lar birbirleriyle tam bant genişliğinde iletişim kurabiliyor. Bu sayede geliştiriciler, bir gecikme kısıtı altında maksimum verimi sağlayacak şekilde en iyi paralellik haritalarını seçebiliyor. Ayrıca NVLink Switch iletişimi, GEMM işlemleriyle aynı anda çalıştırılabiliyor.
Sonuç olarak, Hopper, Llama 3.1 405B ve Llama 2 70B Interactive gibi yeni iş yüklerinde bile güçlü performans sunmaya devam ediyor.
NVIDIA platformu ayrıca, uzman karışımı (Mixture of Experts – MoE) mimarisini kullanan Mixtral 8x7B benchmark’ına da sonuç sunan tek platformdu. GPT-J benchmark’ında ise Hopper, ilk tanıtıldığından bu yana offline senaryoda 2.9x, sunucu senaryosunda 3.8x performans artışı sağladı.
Sonuç: Blackwell ile Geleceğin AI Performansı
NVIDIA Hopper platformu, MLPerf Training ve Inference benchmark’larında üstün performans sunarak hâlâ sektörde lider konumda. Yazılım optimizasyonlarıyla, AI altyapı yatırımlarının ömrünü uzatırken yeni kullanım senaryolarına da destek sağlıyor.
Blackwell mimarisi ise yeni performans ve enerji verimliliği standardını belirliyor. Blackwell, mevcut iş yüklerinde büyük performans kazanımları sunarken, yapay zekâ akıl yürütme gibi daha zorlu senaryolar için daha da büyük kazanımlar sağlıyor. Böylece bir sonraki AI inovasyon dalgasının önünü açıyor.
Ayrıca NVIDIA, Hopper ve Blackwell GPU’ları üzerinde çalışan Dynamo ile yapay zekâ akıl yürütme yeteneklerini ölçeklendiriyor.